
2026 年社媒数据 MCP 服务器架构:静态工具列表 vs 动态 Search-Inspect-Run
对比 2026 年社媒数据 MCP 的静态工具列表、裁剪列表与动态 Search-Inspect-Run 架构:拆解上下文 Token 开销、Prompt Cache 稳定性、工具选错风险及 BeatAPI 固定 7 工具落地契约。
分享至


对比 2026 年社媒数据 MCP 的静态工具列表、裁剪列表与动态 Search-Inspect-Run 架构:拆解上下文 Token 开销、Prompt Cache 稳定性、工具选错风险及 BeatAPI 固定 7 工具落地契约。
分享至
**在 2026 年为 AI Agent 接入公开社媒数据(Public Social Media Data)时,静态工具列表(Static Tool Lists)适合范围固定在 1 到 3 个平台且经过显式裁剪的窄工作流,而动态 Search-Inspect-Run 架构适合跨平台调研、多能力串联、需要维持 Prompt Cache 稳定并在扣费前核验参数与价格的 Agent 系统。**两种架构都能读取公开帖子、主页与评论,核心分歧在于 MCP 服务器如何在 tools/list 阶段组织数百至上千个社媒端点,以及如何防止庞大原始 JSON 撑爆模型的推理上下文。
静态工具列表 MCP 服务器将每个社媒 REST 端点一对一映射为独立 MCP 工具,并在连接初始化时把全部工具 Schema 注入模型提示词。动态 Search-Inspect-Run MCP 服务器将完整动作目录留在服务端,只向模型暴露固定的极少量元工具(Meta-Tools),让 Agent 按自然语言检索候选动作、在扣费前免费检查单个契约与实时报价,再以受控预览模式执行并按需取回完整字段。
tools/list 预先过滤到 1–2 个平台的 10–20 个高频工具可以缩减初始 Schema 体积,但研究任务一旦跨越预设平台就必须修改配置并重连,且未截断的社媒原始 JSON 仍会在多轮对话中迅速挤占上下文。notifications/tools/list_changed 增删工具会击穿模型服务商的前缀缓存;固定元工具清单(例如 BeatAPI MCP 的 3 个核心能力元工具仅占 6,418 字符)让 tools 数组跨轮次零变动,并在执行前提供免费契约与报价检查。**公开社媒数据 MCP 服务器(Public Social Media Data MCP)的端点规模极易突破 1,000 个,因为每个社媒平台都拥有独立的对象模型、主键格式与只读查询界面。**评估架构之前,必须先把公开社媒数据 MCP 与社媒发布类 MCP 区分开,两者在工具数量、鉴权边界与安全风险上完全不同。
社媒发布与账号运营类 MCP 服务器依赖品牌自有账号的 OAuth 授权,通常只包含 10 至 40 个工具,用于创建草稿、排期发帖、处理收件箱与读取自有后台报表。平台官方推出的广告 MCP(例如 Meta Ads MCP 与 TikTok for Business MCP)同样面向已授权的广告账户管理,不提供跨平台公开有机内容抓取。
公开社媒数据 MCP 服务器面向竞品调研、创作者筛选、评论区痛点挖掘与舆情追踪,只读取公开主页、帖子、评论树、关键词搜索与视频字幕,不持有自有账号的写权限。即便是单一内容平台,也会拆出资料、作品列表、单帖详情、关键词搜索、话题搜索、一级评论、评论回复与趋势榜等几十个独立接口。当一个服务器同时覆盖 20 个以上的全球与区域社媒平台,底层动作总数就会自然迈过 1,000 大关。哪怕只看单个平台的广告域,TikTok for Business 官方 MCP 文档也区分了平铺模式的约 400 个工具与渐进模式的约 40 个工具,直观体现了社媒域接口天然的规模压力。
**在 Model Context Protocol(MCP)协议层,社媒数据服务器管理海量端点的方式分化为三种模式:静态全量工具列表(Static Flat Tool List)、静态裁剪工具列表(Scoped Static Tool List)以及动态 Search-Inspect-Run(固定元工具 + 渐进式发现)。**三种模式决定了 tools/list 在连接初始化时返回多少定义,以及完整参数 Schema 何时进入模型上下文。
静态全量工具列表将后端每条 REST 路由一对一展开为具名 MCP 工具(常见命名为 {platform}_{resource}_{action}),并在客户端执行 tools/list 时一次性下发全部文字说明与 inputSchema。当服务器总工具数低于 15 个且定义紧凑时,模型可以在单轮推理中直接发起强类型调用;当端点膨胀至数百乃至上千个时,静态平铺会把巨量 Schema 强行塞进每一轮请求的提示词前缀。
静态裁剪工具列表延续“1 端点 = 1 工具”的底层映射,但允许开发者通过连接地址的查询参数(按平台前缀、场景预设或工具组)缩减 tools/list 的返回范围。只关注 TikTok 主页和 YouTube 评论的团队可以在配置阶段把工具清单压回几十个以内。部分采用该模式的服务端会附加一个自然语言兜底路由工具,用于覆盖预设之外的查询;但这类单步路由往往在匹配完成后立即执行并扣费,缺少独立的执行前参数与价格核对步骤。
动态 Search-Inspect-Run 落实了 MCP 客户端最佳实践定义的三层渐进发现架构(Catalog → Inspect → Execute),将目录检索与契约下发收回服务端。在 tools/list 阶段,服务器始终只暴露固定不变的极少量元工具:Search 接收自然语言并返回轻量候选卡片;Inspect 免费返回单个选定动作的完整 input_schema、实时报价、就绪状态与可复制的下一步调用模板;Run 按精确引用执行,并在统一出口处控制预览截断与按需取回。
| 工程评估维度 | 静态全量工具列表 | 静态裁剪工具列表 | 动态 Search-Inspect-Run |
|---|---|---|---|
tools/list 暴露形态 | 数百至 1,000+ 个按端点展开的具名工具 | 开发者预选的平台或工具组子集(通常 10–60 个工具) | 固定 3 个核心元工具(Search / Inspect / Run),可并列极少数高频独立工具 |
| 首轮上下文开销 | 极高;首轮提问前即消耗数万至十余万 Token | 中低;随勾选平台数量线性增长 | 极低且恒定;底层新增 500 个动作也不会撑大 tools/list |
| 跨平台即兴探索 | 全平台均在列表内,但密集 Schema 显著抬高误选率 | 受限;跨出预设平台时需人工改配置 URL 并重连 | 原生支持;Agent 在同一会话内按需发现任意已覆盖平台 |
| Prompt Cache 稳定性 | 数组固定,但携带庞大的未裁剪前缀基线 | 单会话内稳定;切换裁剪范围需重建缓存前缀 | 最优;跨轮次、跨平台切换时 tools 数组字节级不变 |
| 扣费前参数与价格预检 | 弱;价格与限制依赖静态描述或外部文档 | 弱;自然语言兜底路由常在匹配后直接扣费执行 | 原生内置;免费 Inspect 返回必填入参、实时单价、计费单位与就绪状态 |
| 首次陌生动作延迟 | 1 轮工具往返(前提是首次选对工具与参数) | 1 轮工具往返(仅限当前预设子集内工具) | 2–3 轮工具往返(Search → Inspect → Run);按哈希缓存契约后缩为 1 轮 |
| 大载荷防上下文撑爆 | 通常直接回传完整 REST JSON 进入对话历史 | 通常直接回传完整 REST JSON 进入对话历史 | 在统一 Run 入口内置默认预览截断、fields 裁剪或分阶段取回 |
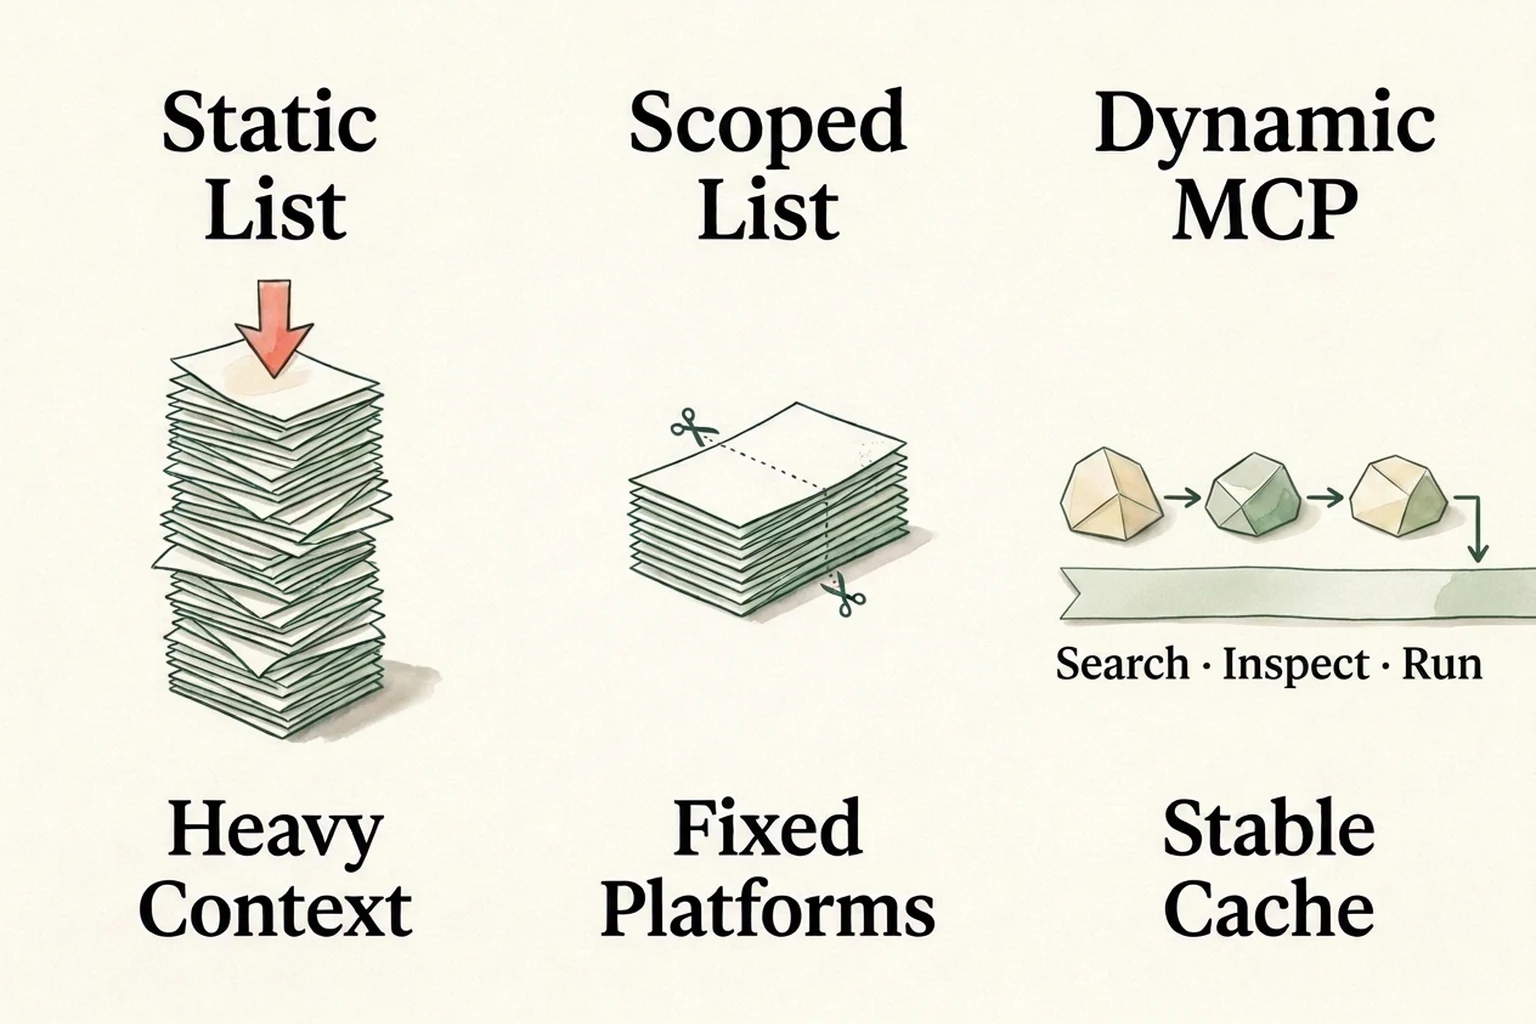
当社媒数据 MCP 覆盖几十个平台与细粒度抓取动作时,静态工具列表会同时触发四个可量化的工程瓶颈:首轮上下文 Token 税、相似端点误选与参数幻觉、动态改表引发的 Prompt Cache 失效,以及未截断社媒 JSON 造成的载荷污染。
每个静态暴露的 MCP 工具都携带名称、描述、JSON Schema 属性树、枚举约束与必填项定义,工具数量一旦上百,固定开销便迅速失控。Atlassian 工程团队实测官方 GitHub MCP 服务器的 94 个工具消耗约 17,600 Tokens,Jira 与 Confluence 工具合计约 10,000 Tokens。Anthropic 工程报告记录了一组 5 个服务器共 58 个工具消耗约 55,000 Tokens,50+ MCP 工具消耗约 72,000 Tokens,优化前内部环境最高达到 134,000 Tokens;MCP 客户端最佳实践亦指出多服务器全量加载可达约 150,000 Tokens,而渐进式发现仅需约 2,000 Tokens。对同时挂载代码库、文档与网页工具的 Agent 而言,一个上千工具的静态社媒 MCP 足以挤占核心推理窗口。
工具膨胀不仅推高输入账单,更会直接降低模型调用的准确度。Anthropic 内部 MCP 评测显示,将全量预加载切换为按需检索后,Claude Opus 4 的准确率从 49% 升至 74%,Claude Opus 4.5 从 79.5% 升至 88.1%。社媒数据目录尤其容易触发命名冲突:各平台反复出现“查主页”“拉帖子”“搜关键词”“读评论”“拉回复”等近似动作,但主键规则互不兼容——TikTok 区分 uniqueId、secUid 与 itemId,YouTube 评论要求精确 11 位 video_id,小红书笔记详情必须同时传入 note_id 与 xsec_token。把上千个相似定义同屏塞入上下文,极易诱发跨平台参数串用。
list_changed 增删工具会击穿 Prompt Cache部分 MCP 架构试图通过协议通知 notifications/tools/list_changed 在对话中途动态注册或卸载工具。MCP 客户端最佳实践明确提醒这一做法的缓存反噬:主流模型服务商会缓存包含系统提示词与 tools 数组在内的请求前缀,会话中途增删或重排工具定义会直接导致前缀缓存失效,重算输入 Token 的开销往往大于精简工具省下的体积。规范给出的稳妥方案正是通过固定元工具路由执行,使 tools 数组在整场会话中保持字节级稳定。
一页社媒评论、创作者作品或搜索结果往往返回 30 KB 至 100 KB 以上的嵌套 JSON,夹杂多分辨率封面地址、作者嵌套对象与平台内部标识。静态端点封装通常将完整 REST 响应原样回传进对话历史,后续每一轮模型推理都要重复读取这些冗余载荷。动态架构则能在统一的 Run 边界集中实施默认预览截断,仅在模型确有必要时按字段路径二次提取。
**动态 Search-Inspect-Run 并非无条件优于静态列表:它的效果取决于服务端目录的检索召回质量,会在首次执行陌生动作时引入 1 至 2 轮额外延迟,且在保留高细粒度动作时不一定提供跨平台完全一致的输出字段树。**落地前必须明确这三条边界。
在动态模式下,如果第一步 Search 没有把正确动作放进候选列表,后续推理再强也无法正确调用。MCP 客户端最佳实践对比了关键词匹配(BM25 / 正则)、向量检索、子模型路由与混合检索四类策略:纯字面匹配容易漏掉同义表达与跨语言提问,模糊的工具说明也会拖累各类检索器的命中率。成熟的动态服务端必须配合清晰的候选卡片、匹配理由与缺失字段提示,同时在客户端指令中要求 Agent 先通过 Inspect 核对必填入参,绝不盲目执行搜索排位第一的结果(例如检索 YouTube 视频评论时,需要续页令牌的回复接口可能排在主评论接口之前,查契约即可提前避坑)。
Anthropic 官方文档明确指出,当工具库少于 10 个、定义紧凑且每轮会话都会用到全部工具时,按需检索的额外往返收益偏低;MCP 客户端最佳实践同样建议在工具定义低于上下文窗口 1%–5% 时直接加载。即便接入了动态服务器,连续查询 30 个同一平台账号时也不该每次都重复 Search 与 Inspect——工程上应按服务端返回的 16 位 schema_hash 在会话内缓存已核验契约,并将周期性批量采集迁移到直接 REST 接口。
覆盖 1,000+ 平台原生动作的目录通常能为所有动作发布严谨的输入 Schema 与报价,但部分平台结构变动频繁,其动作就绪状态会标为 runnable(输入与价格已发布,完整输出 Schema 未预声明)。调用这类动作时,Agent 必须先读取预览返回的真实数据结构,再决定下游提取路径,而不能凭经验假定每个平台都返回同名的 followers 字段。
架构选择应基于四个可核验的工程约束——单次会话涉及的平台数、端点范围在会话前是否已知、是否需要与非社媒能力协同,以及对上下文预算和 Prompt Cache 的敏感度——而不是单一维度的工具总数。
| 业务与工程场景 | 核心约束与卡点 | 推荐架构 | 关键落地守则 |
|---|---|---|---|
| 固定 1–2 个平台的轻量助手(总工具数 < 15) | 任务范围完全确定,追求单轮最低延迟 | 静态裁剪工具列表 | 将 tools/list 严格限定在 10–15 个高频端点,不挂载未使用的全量目录。 |
| 跨平台创作者、帖子与评论调研(兼顾全球与中文社媒) | 对话前无法预知需要组合哪些平台与抓取维度 | 动态 Search-Inspect-Run | 强制先免费 Inspect 核对必填入参与单价,再以预览模式执行,禁止模型手拼动作 ID。 |
| 端到端研究与内容生产 Agent(社媒 + SEO + 联网检索 + AI 模型) | 堆叠多个独立 MCP 会挤爆上下文、击穿缓存并割裂密钥与账单 | 动态 Search-Inspect-Run 统一能力层 | 用固定元工具清单覆盖数据与模型能力,保持 tools 数组稳定以保住 Prompt Cache。 |
| 固定账号清单的每日定时抓取与入库 | 不需要 LLM 自主推理路由,看重吞吐、确定性与零推理成本 | 直接 REST API / SDK(脱离 MCP) | 用 MCP 完成探索和契约核验,把稳定请求体下沉至定时脚本或后端作业。 |
BeatAPI MCP(https://beatapi.io/mcp)用固定不变的 7 工具清单(3 个核心能力元工具 + 4 个专用 Web 工具)完整落地了动态 Search-Inspect-Run 架构,在单一 API Key 下覆盖跨 23 个平台的 1,021 个社媒数据动作,并同步联通 SEO 数据、联网检索与 70+ AI 模型。
在 BeatAPI 公开的 MCP 工具清单(capabilities-mcp-tools.json)中,tools/list 始终只返回 7 个工具:capabilities_search、capabilities_inspect 与 capabilities_run(3 个核心能力元工具合计 6,418 字符),以及 web_search、web_read、web_map 与 web_research(7 个工具总计 15,725 字符)。无论服务端持续扩充多少社媒动作或模型版本,客户端拿到的 tools 数组始终不变,不会因 list_changed 破坏长会话的 Prompt Cache。
在这组恒定元工具之后,BeatAPI Social Data 目录聚合了 23 个平台共 1,021 个社媒动作,同时覆盖全球主流平台与中文/亚太深度生态:抖音(317 个动作)、TikTok(164 个)、Instagram(93 个)、B 站(87 个)、微博(56 个)、小红书(44 个)、知乎(41 个)、快手(38 个)、YouTube(33 个)、X / Twitter(25 个)、Reddit(24 个)、微信视频号(12 个)、微信公众号(11 个)及 LinkedIn(8 个)。如果 Agent 在挖完评论区痛点后需要立刻核查关键词竞争度、读取竞品页面或产出创意素材,无需接入第二个 MCP 服务器,同一连接即可调用 BeatAPI SEO Data(data:seo.*)、BeatAPI Web Search 以及文本、图像和视频模型,并顺接 社媒原帖转来源链接研究简报流程 保留完整出处。
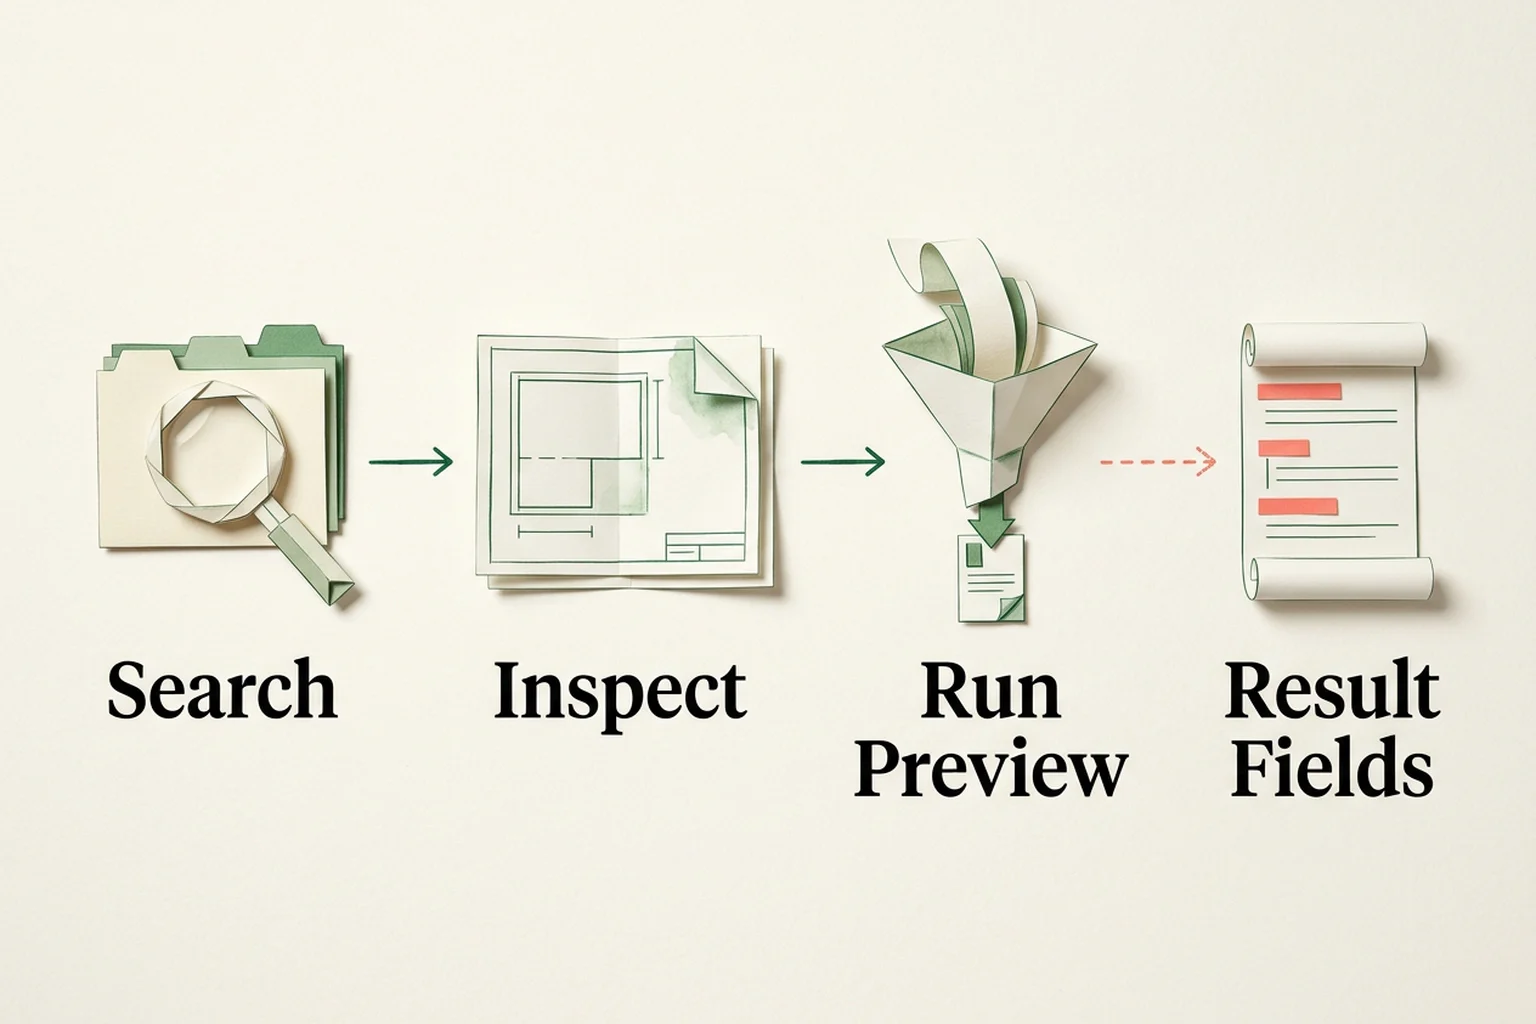
在 Codex、Claude Code 或 Cursor 中接入 https://beatapi.io/mcp 时,不要把客户端的“已连接”绿点当作验收完成,应按顺序验证以下四个独立边界(各客户端排障细节见 BeatAPI MCP 端到端连接与验证指南):
**第一步:通过环境变量注入密钥并确认工具清单可见。**配置远程 MCP 地址 https://beatapi.io/mcp 与环境变量 BEATAPI_API_KEY,避免把真实密钥写入仓库或聊天记录:
[mcp_servers.beatapi]
url = "https://beatapi.io/mcp"
bearer_token_env_var = "BEATAPI_API_KEY"
先让 Agent 列出当前会话实际可见的工具名,确认 capabilities_search、capabilities_inspect 与 capabilities_run 均已就绪,再进行下一步。
**第二步:调用 capabilities_search 免费检索候选动作。**使用中英文描述“平台 + 动作”并设置 kind: "data",严格复制服务端返回的 reference,不要按平台名自行拼凑动作 ID:
{
  "query": "tiktok user profile",
  "kind": "data",
  "limit": 5
}
**第三步:调用 capabilities_inspect 免费核对入参、实时报价与就绪度。**发起扣费执行前,先拉取单个动作的完整契约:
{
  "reference": "data:tiktok.web.fetch_user_profile"
}
重点核验四项字段:input_schema 中的必填参数与格式、pricing 中的实时美元单价与计费单位(billing_unit)、execution.mode(社媒数据为同步 sync,无需轮询任务状态),以及 readiness(ready 表示输入、输出与价格均已发布;runnable 表示输入与价格已发布,输出字段需从实际响应读取;listed 不可经 Run 执行)。保存返回的 16 位 schema_hash,同一工作流复用该动作时即可跳过重复 Inspect。
**第四步:带 view: "preview" 与 idempotency_key 受控运行并按需取全量。**BeatAPI MCP 默认为 capabilities_run 的 start 启用 view: "preview",自动将主列表提升至 items(默认 10 条、上限 50 条)并缩短过长文本,避免原始社媒 JSON 淹没上下文;顶层 idempotency_key 防止网络超时重试时重复扣费:
{
  "reference": "data:tiktok.web.fetch_user_profile",
  "operation": "start",
  "input": {
    "uniqueId": "YOUR_TARGET_HANDLE"
  },
  "view": "preview",
  "max_items": 10,
  "idempotency_key": "tiktok-profile-check-20261121-001"
}
读取返回结果时先检查 isError——BeatAPI 将网关 4xx/5xx 响应按 MCP 规范以 HTTP 200 搭配 isError: true 返回,确保模型能读到原始错误 JSON 并自纠——随后保留 request_id 与 usage。若预览结果标记为 truncated 且你需要完整数据或特定键,不要重复发起 start 二次扣费,而是在 1 小时内用同一密钥、原 reference 与 request_id 调用 operation: "result"(可配合 fields 如 ["items[].title", "items[].url"])免费取回。
按 BeatAPI 公开 Social Data 计费契约,capabilities_search、capabilities_inspect、1 小时内的 operation: "result" 重拉以及失败调用均不扣费。标准按次社媒动作的公开观察价常见为每次成功请求 $0.003;按创作者计费的 creator.discover 与 creator.contacts 观察价为每位创作者 $0.006(成功但返回空列表时最少计 1 个创作者单位),批量执行前请始终以 capabilities_inspect 的实时报价为准。遇到空数组或错误信封时,可结合 社媒数据空结果五步排障指南 与 失败调用与空结果计费对账指南 准确区分故障、无匹配与实际计费单位。
一次性向首轮提示词塞入上千个社媒端点 Schema 会造成严重的命名碰撞(各平台反复出现 profile_get、posts_list、comments_list 却使用互不兼容的主键参数),显著分散模型注意力。Anthropic 内部 MCP 评测显示,改用按需检索后,Claude Opus 4 的准确率从 49% 提升至 74%,Claude Opus 4.5 从 79.5% 提升至 88.1%。
如果 Agent 长期只停留在 1 到 2 个固定平台且工具数不超过 15 个,静态裁剪列表已经足够轻量且具备单轮直调优势。但一旦工作流需要在会话中途临时扩展到新平台,或需要内置扣费前实时报价检查与预览截断防爆上下文,动态 Search-Inspect-Run 更能减少维护与 Token 损耗。
list_changed 会破坏 Prompt Cache?主流模型 API 会缓存包含系统提示词与 tools 数组在内的请求前缀。如果在对话中途通过 notifications/tools/list_changed 增删或重排工具定义,前缀字节变化会直接触发缓存失效,重算开销可能超过精简工具省下的 Token。采用固定的元工具清单(如 BeatAPI 的 7 工具接口)可以让 tools 数组全程保持稳定。
首次调用陌生动作时,Search 与 Inspect 会增加 1 至 2 轮工具往返,但这两步在 BeatAPI MCP 中免费,且仅 6.4 KB 的核心元工具定义避免了每轮对话重复为数百个静态 Schema 付费。同一工作流复用已验证动作时,按 16 位 schema_hash 缓存契约即可直接执行 Run;固定高频任务则应直接迁移至 REST API。
不能仅靠 HTTP 200 或“业务层没有拿到可用记录”判断是否扣费。先核查 MCP 返回的 isError、网关状态信封、request_id 与 usage:在 BeatAPI 契约中,失败调用不消耗余额;按次计费动作在成功返回时计 1 次请求,按创作者计费的 creator.discover 与 creator.contacts 在成功空结果时最少计 1 个创作者单位。
MCP 适合交互式探索、代码助手原型开发以及需要模型自主决定查哪些平台的研究型 Agent。当业务收敛为固定账号清单、固定分页规则与每日定时入库时,直接调用 POST /v1/social-data/call 等 REST 端点可以完全省去 LLM 推理延迟与 Token 账单,并获得更可控的并发与幂等重试能力。
在为生产环境 Agent 选定社媒数据 MCP 架构之前,先用一条真实的多步骤任务(例如“按关键词找到一条公开帖子并拉取前 10 条评论”)做一次 10 分钟基线核对,重点观察三项指标:初始化 tools/list 占用的上下文体积、长评论响应是否支持默认预览截断与按字段提取,以及扣费前能否免费核对必填参数与实时报价。如果你的工作流横跨全球与中文社媒平台,或计划把社媒洞察直接串联到 SEO、联网检索与模型生成,可以直接从 BeatAPI Social Data 目录 和 BeatAPI MCP 客户端集成页 跑通第一条受控验证请求。